GUITAR AI / COMPUTER VISION
Virtualな演奏動画を作りたくて、ギターを切り抜くAIを作っている
MediaPipe Handsから始まった、自分のギター専用Segmentation AIの試行錯誤。
「Virtualな演奏動画」と言っても、最初から完成形があったわけではありません。
作りたかったのは、実際にギターを弾いている映像に、手や指の動きに連動したOverlayやエフェクトを重ねて、現実とVirtualが自然に混ざった演奏動画です。
以前、MediaPipe Handsを使って、左右の手や指の位置を検出し、その上にOverlayを表示する仕組みを作っていました。手の動きに反応して視覚表現を重ねるだけでも面白く、「これをもっと自然に見せられないか」と考えるようになりました。
まずは、以前作っていたHands Overlay
ここで一つ問題がありました。指の位置が分かるだけでは、現実とVirtualをきれいに混ぜられないことです。
Overlayの一部をギターの後ろに隠したり、逆にギターより手前へ表示したりしたければ、「このPixelはギターなのか?」を知る必要があります。
自分のギターだけを切り抜けるAIを作ればいいのでは?
これが、Guitar Segmentationを始めた理由です。
今のAIなら、ギターくらい簡単に切り抜けると思っていた
最初は、そこまで難しい問題だとは思っていませんでした。画像Segmentationのモデルを調整すれば、ギターくらいはきれいに抜けるだろう、と考えていました。
実際には、全然そんなことはありませんでした。
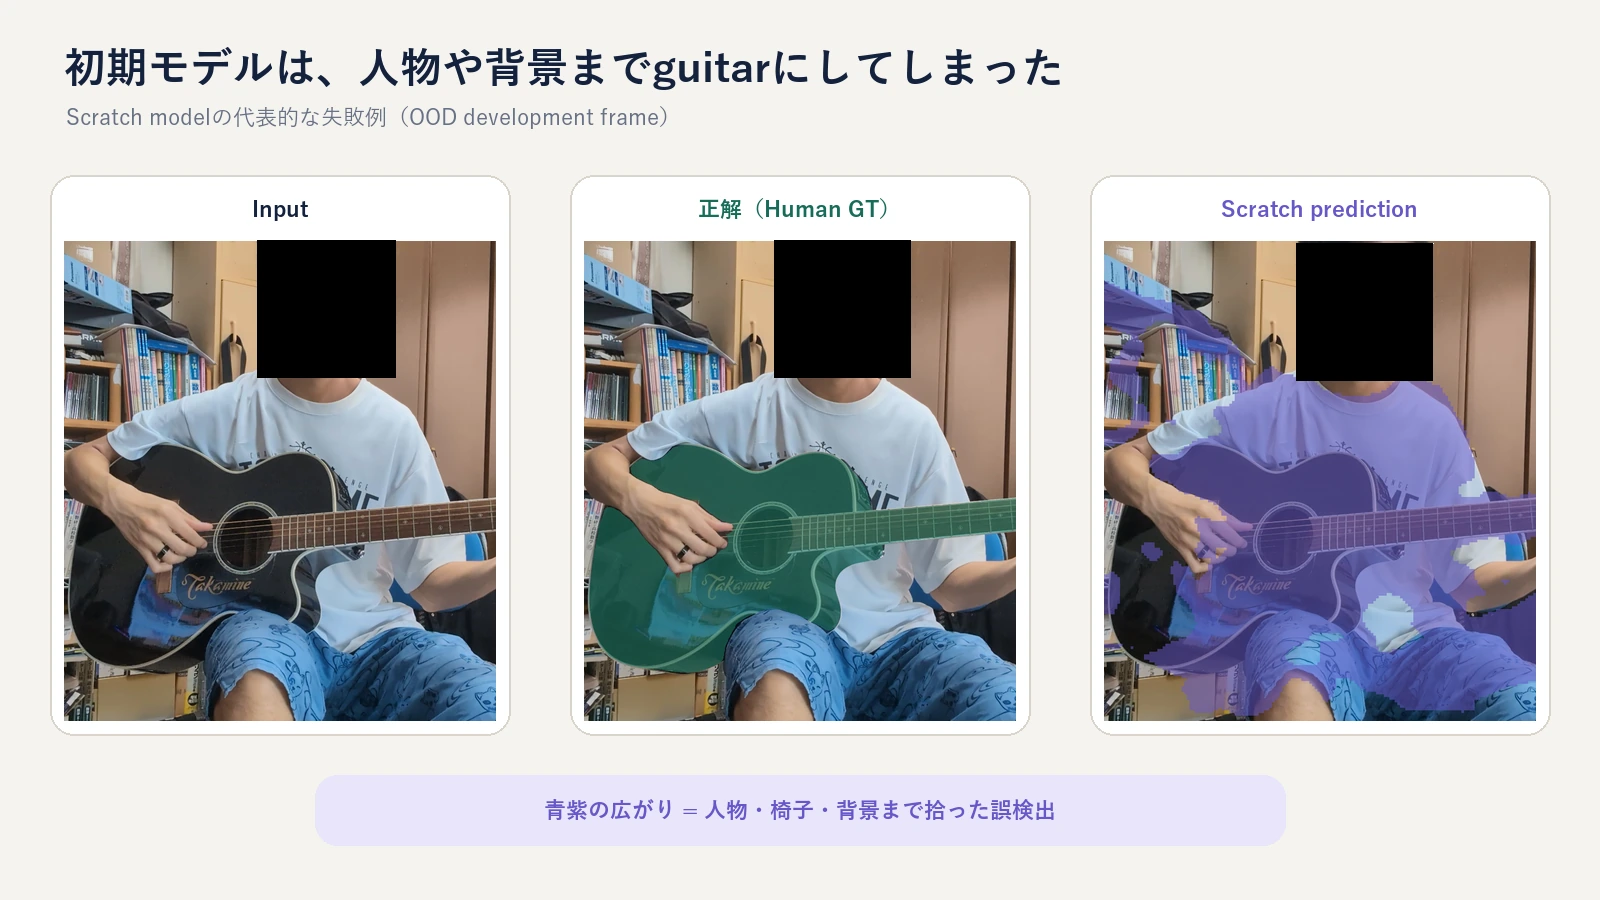
ギターには大きなボディだけでなく、細いネックやヘッドストックがあります。さらに実際の演奏では、手がネックに重なり、腕がボディの前を通り、服とギターが接触します。動けばブレも発生し、金属部分では光の反射も起こります。
ただ「ギターらしい物体」を認識するだけではなく、人間と接触しながら動いているギターの輪郭をPixel単位で取るとなると、一気に難しくなりました。
なら、自分でAIの教材を作ればいい
自分のギター専用AIを作るなら、自分のギターをたくさん見せればいい。そう考えて、最初にやったのが撮影環境作りでした。
まずはグリーンバックを用意して、ギターをいろいろな角度から撮影しました。そこからギター部分を切り抜き、別の背景へ合成すれば、大量の学習画像を作れます。
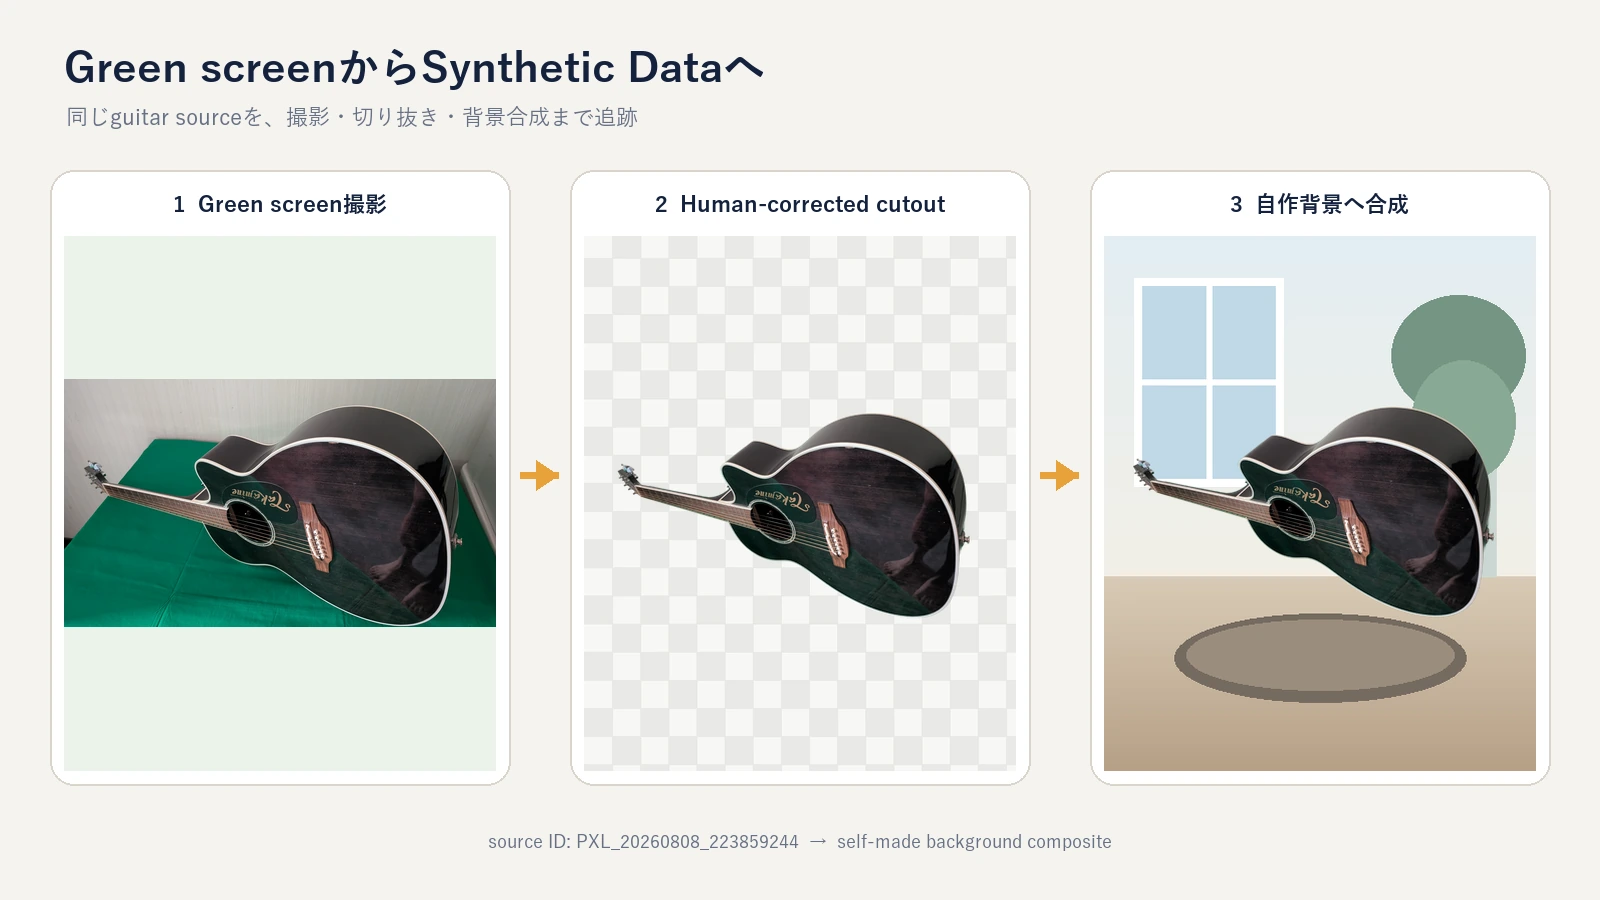
この方法で最終的に作ったSynthetic Datasetは5,000枚になりました。
グリーンバックが、必ずしも最適ではなかった
最初は「背景を緑一色にすれば簡単だろう」と思っていました。しかし実際には、布のしわによる影や照明のムラが出ます。さらにギターのペグのような金属部分には周囲の緑が反射し、SAM3でマスクを作る際にも扱いにくくなることがありました。
そこで途中から、家の白い壁を背景として使う方法も取り入れました。見た目としては専用グリーンバックの方がそれらしいのですが、実際には白壁の方が扱いやすい場面も多くありました。
目的はグリーンバックを使うことではありません。必要なのは、AIにとって扱いやすい教材を作ることです。モデルだけでなく、入力となる素材をどう撮るかもシステムの一部だと感じたポイントでした。
Syntheticだけでは、実際の演奏に届かなかった
Synthetic Dataを増やすことで、ギターそのものの形や角度、位置、スケールの多様性はかなり学習できるようになりました。
ただ、実際の演奏映像にはSyntheticでは再現しにくい要素があります。手がネックを握る。腕がボディに重なる。袖がギターに接触する。つまり、「ギター単体」と「人が持って弾いているギター」はかなり違う問題でした。
そこで、実際の演奏映像そのものを学習データに加えることにしました。
実写データは、SAM3に手伝ってもらって作った
実写データを増やすには、各フレームのギター領域に正解Maskを付ける必要があります。ただ、何百枚・何千枚もの画像をゼロから手で塗るのは大変です。
そこでSAM3にMask候補を作ってもらい、その後で人が確認・修正する形にしました。
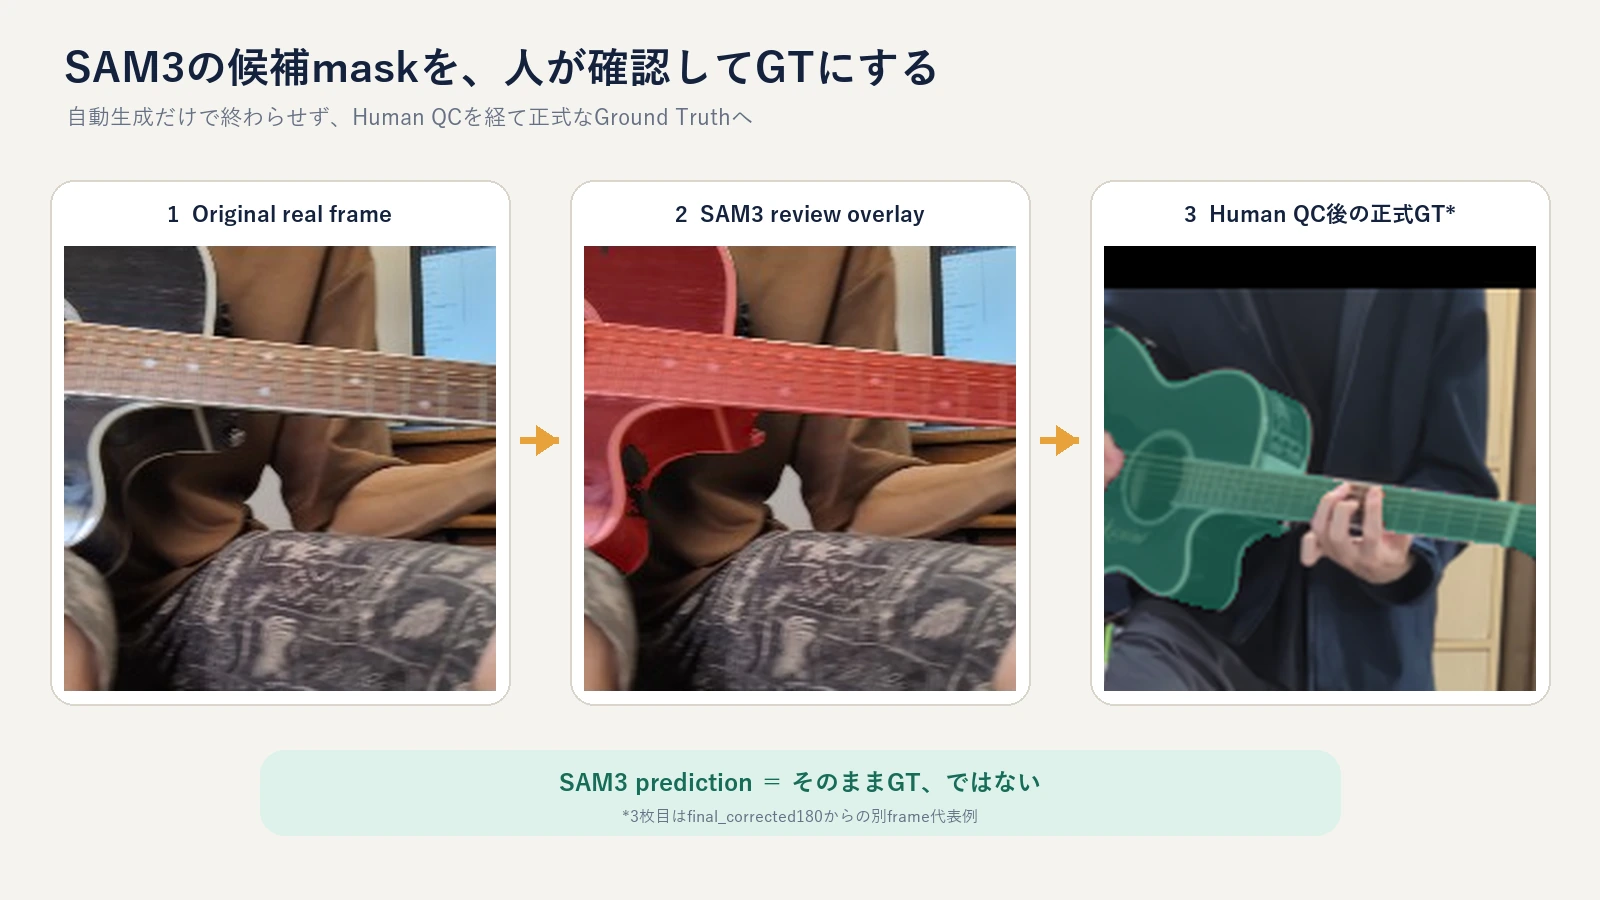
SAM3の出力をそのまま正解にはしていません。あくまで下書きをAIに手伝ってもらい、最後は人が確認するという流れです。
さらに「きれいに写っている演奏画像」だけではなく、手で隠れている、人だけが写っている、ギターだけが写っている、背景だけが写っている、といった、これまでモデルが失敗していたHard-caseを意識して追加しました。
モデルもかなり試した。でも、一番効いたのはデータだった
モデル側でも、Gabor Filter、BiRefNet、ImageNet事前学習、SegRCDB / FDSL、LP-FT、Multi-scale Feature、段階的Fine-Tuningなど、かなりいろいろ試しています。
ただ、第一号記事で一番大きかった変化を一つだけ挙げるなら、それはモデル変更ではありません。学習データの変更です。
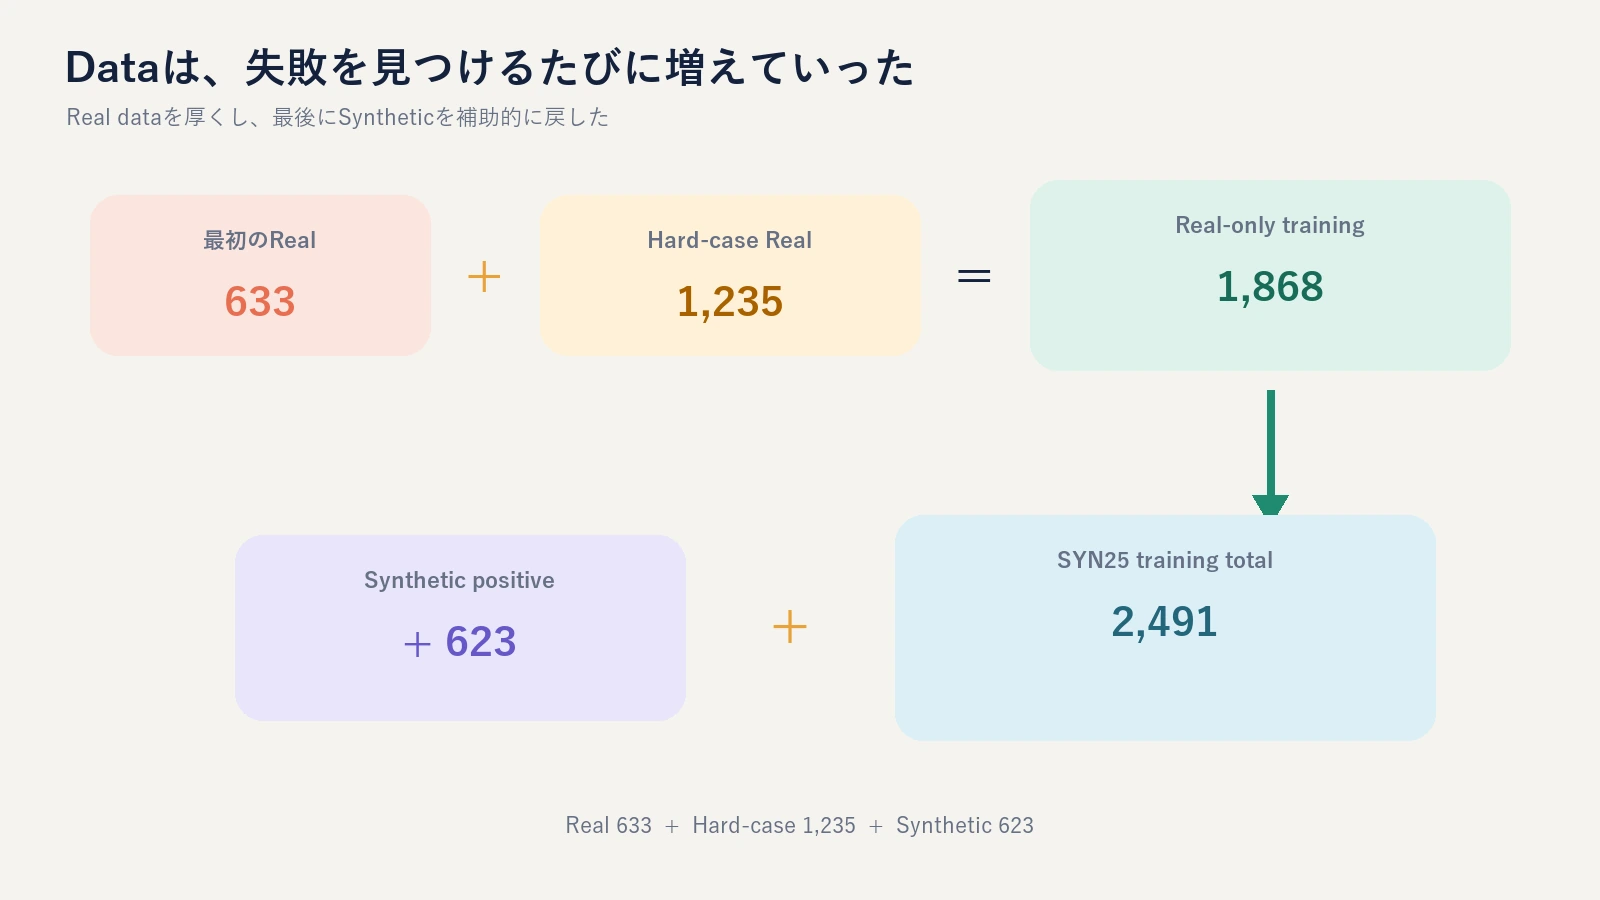
最初の実写学習データは633枚でした。そこへ、モデルが苦手としている条件を狙って追加したReal Data 1,235枚を加え、合計1,868枚に増やしました。
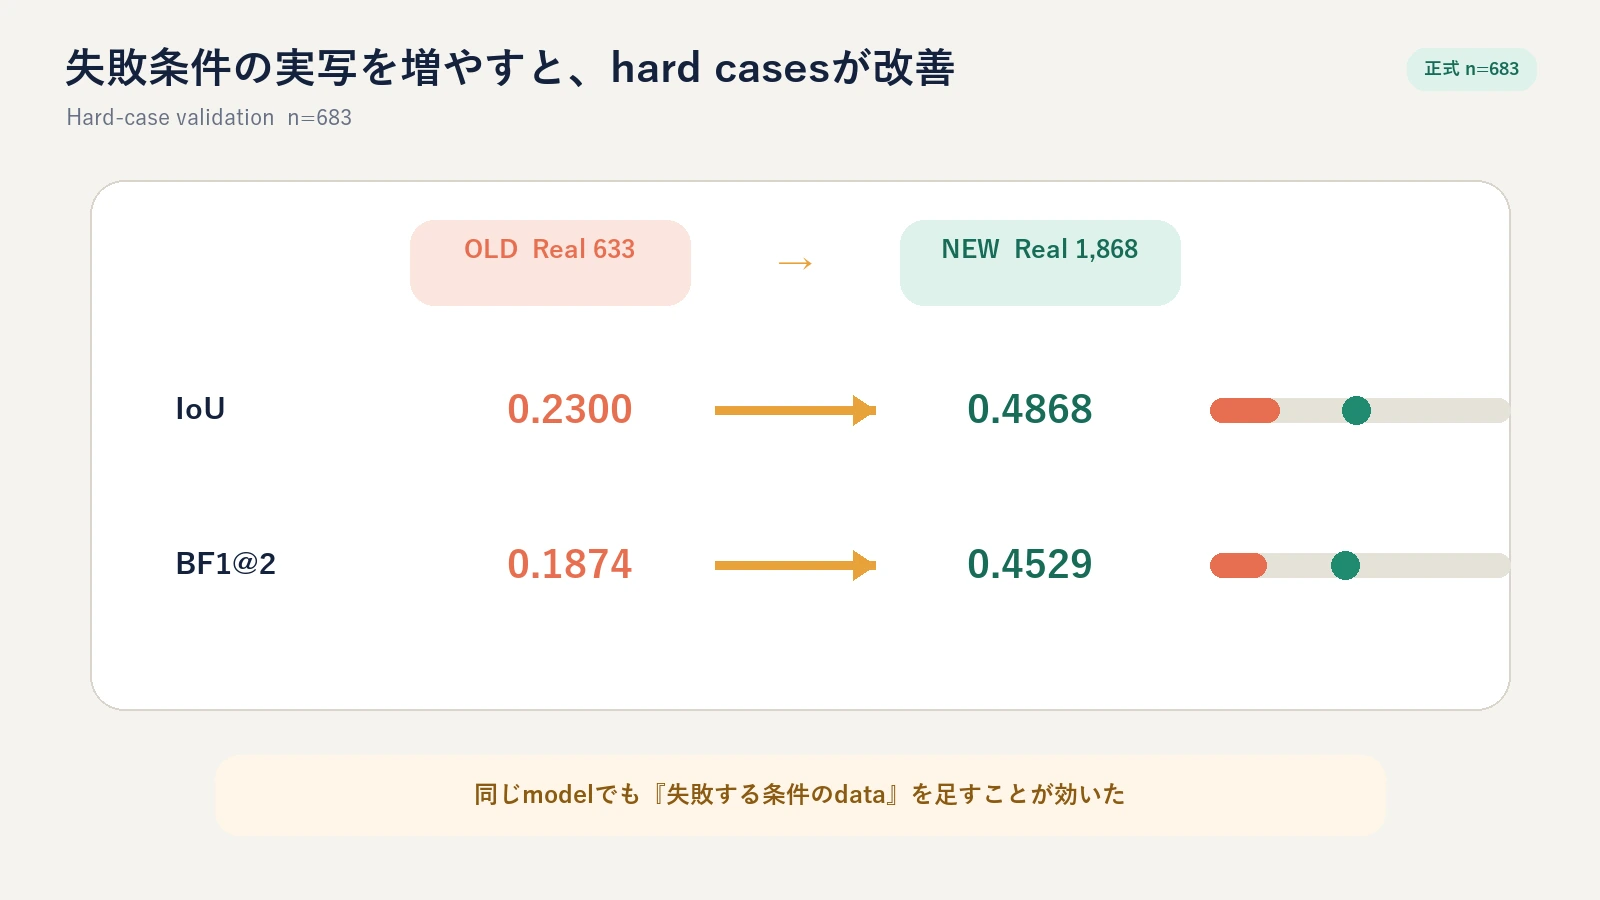
Lossや細かな閾値調整より、はるかに大きい変化でした。
このあたりから、「もっと良いモデルを探す」ことよりも、「今のモデルがどこで失敗しているかを見て、その条件を学習データに入れる」ことの方が重要なのではないか、という感覚がはっきりしてきました。
一度限界を感じたSyntheticを、もう一度使い直した
ここで少し面白かったのがSynthetic Dataです。最初の段階では、Syntheticだけでは実演奏に届かないことが分かっていました。
でも、それは「Syntheticが役に立たない」という意味ではないかもしれない。実写データが十分に増えた状態なら、役割の違う補助データとして効くのではないかと考えました。
Real 1,868枚にSyntheticのPositive Sampleを623枚だけ追加し、合計2,491枚にしました。Syntheticが全体の約25%を占めるので、この条件をSYN25と呼んでいます。
- Real Data:手・腕・袖・接触境界を学ぶ
- Synthetic Data:ギターの形・角度・姿勢・スケールの多様性を補う
その効果を、学習に使っていない新しい演奏動画541フレームで評価しました。
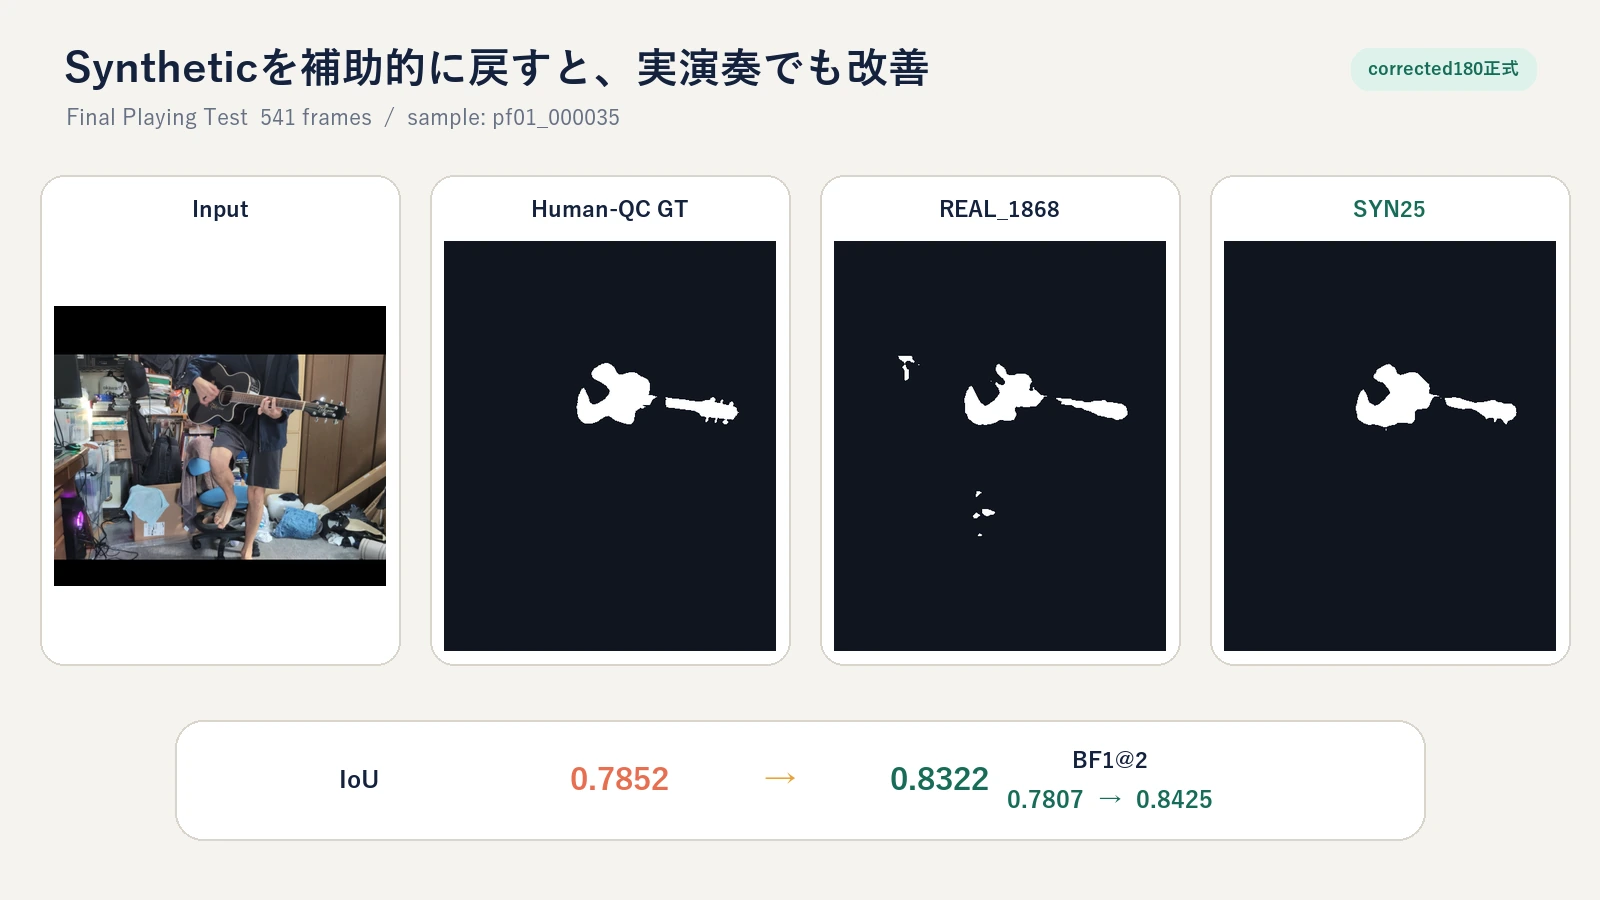
特に興味深かったのは、Precisionをほとんど崩さないままRecallが改善したことです。単純にMaskを広げたのではなく、これまで見逃していたギター領域をより拾えるようになったと考えられます。
今は、ここまで切り抜けるようになった
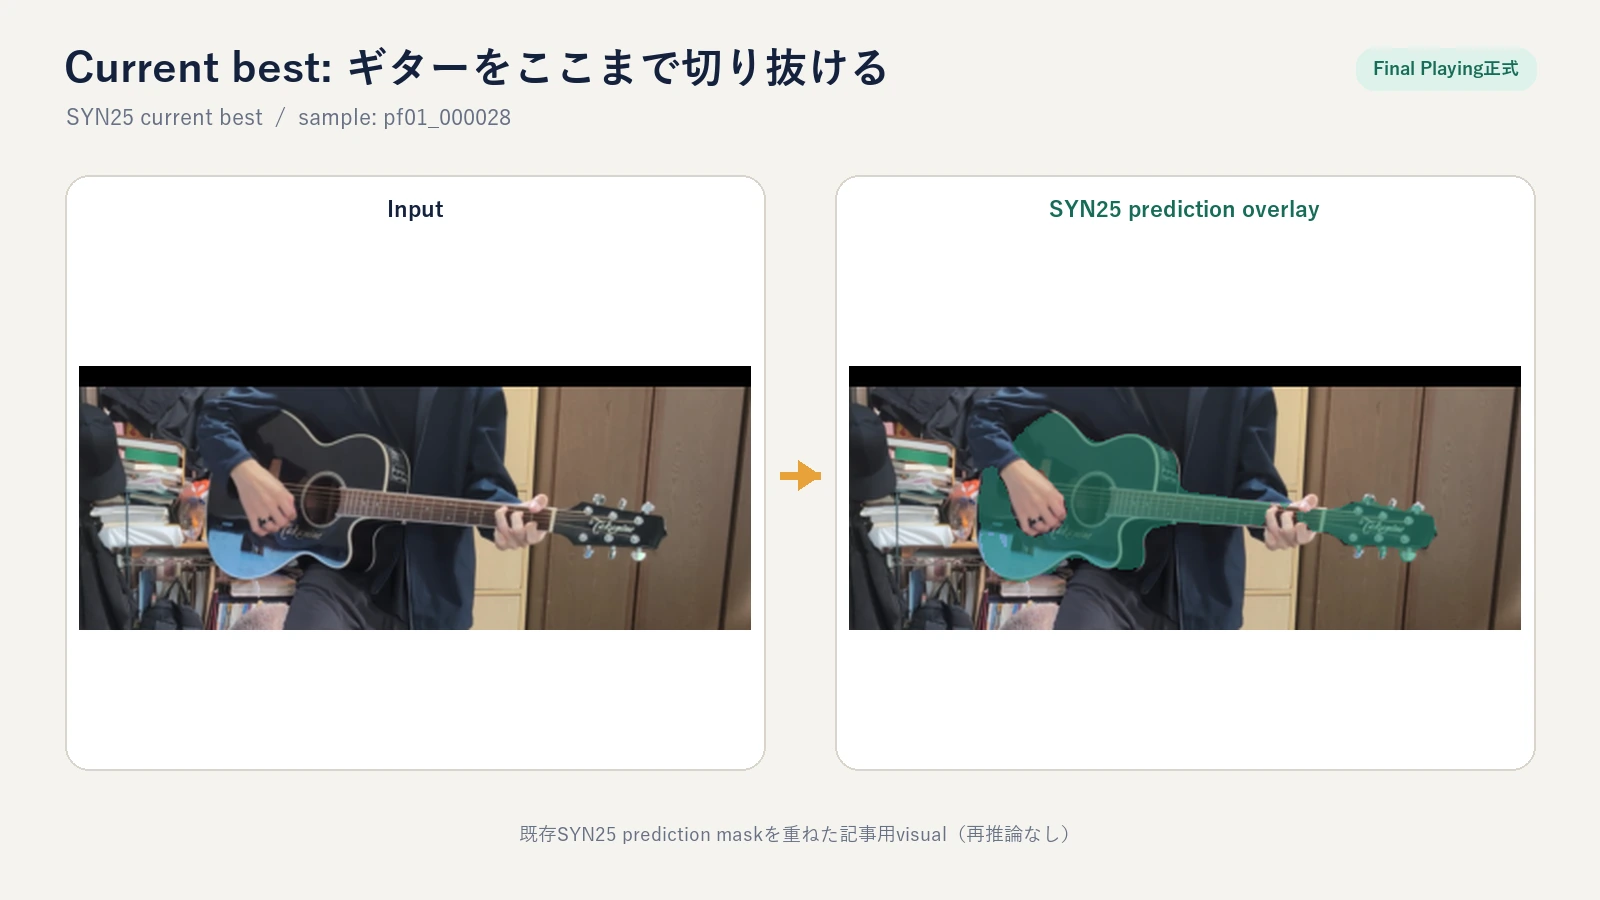
最初に「人も背景も全部ギター扱いしてしまう」状態だったことを思うと、かなり目的に近づいてきました。
ただし、まだ完成ではありません。
それでも、長袖とギターの境界はまだ難しい
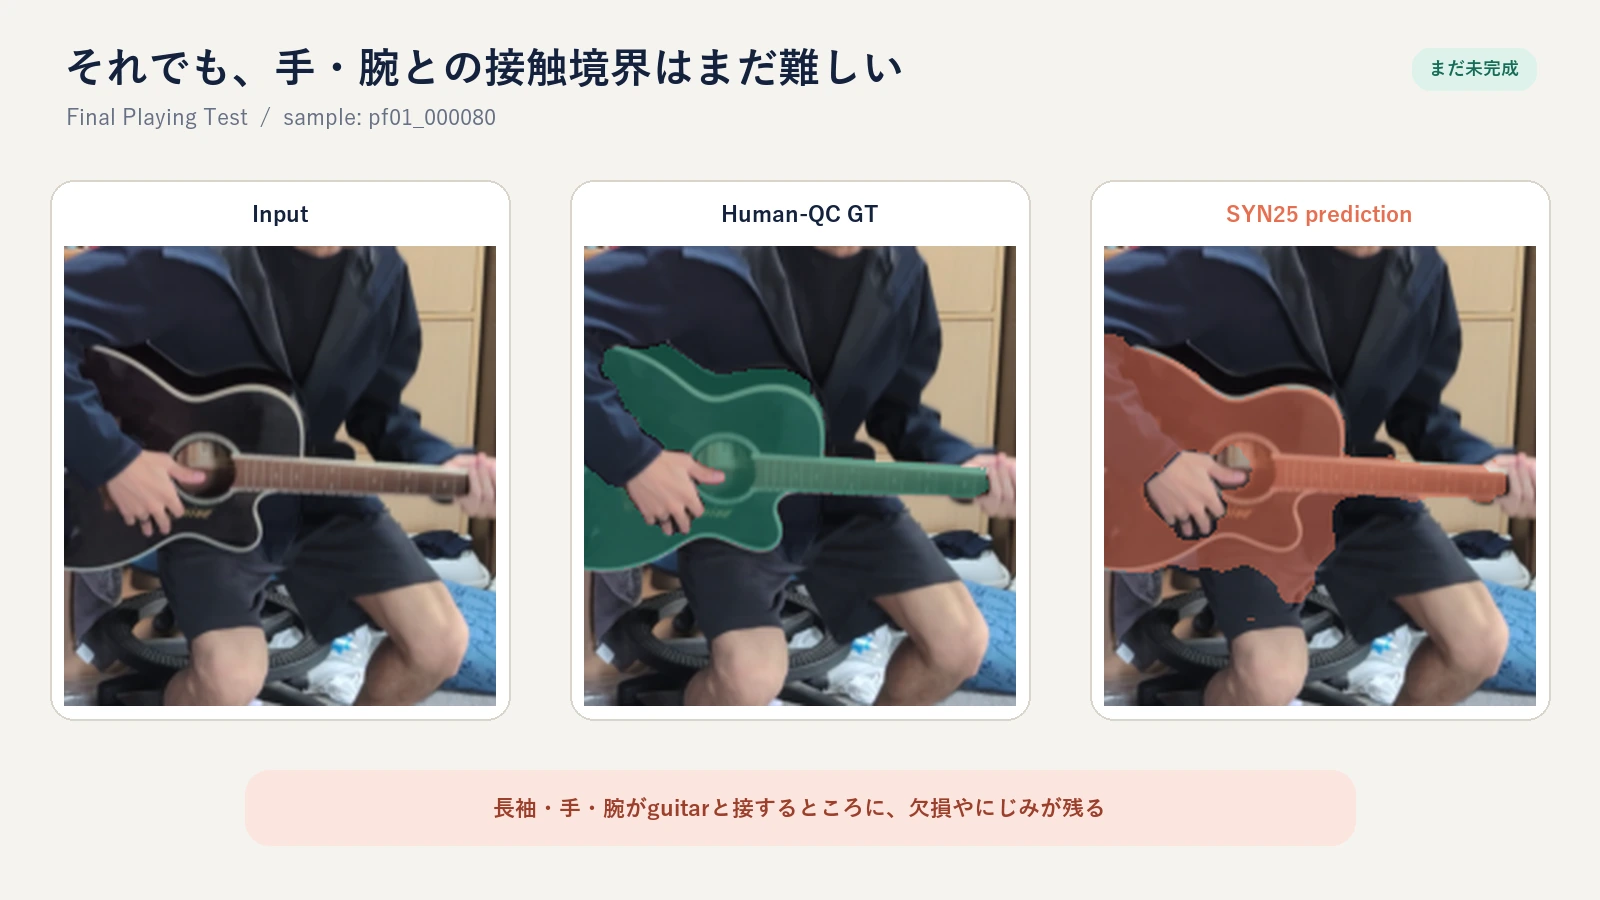
ギターそのものの形はかなり捉えられるようになった一方で、人間とギターが接触している境界をどう分離するかは、まだ次の課題として残っています。
次に効くのは、またモデルを大きく変えることではなく、長袖・手の遮蔽・接触境界のような難条件をさらに意識したデータ追加かもしれません。
そして、実際に重ねてみると、目指していた方向が見えてきた
ここまで作ってきたGuitar Segmentationを、以前作っていたMediaPipe HandsのOverlayと実際に組み合わせてみました。
これは完成版ではありません。境界にはまだ改善の余地がありますし、演出としても粗い部分があります。
それでも、この動画を作ったことで、最初に考えていた方向へ確かに進めている感触が出てきました。
やりたかったのは、単にギターをきれいに切り抜くことではありません。手や指の情報を使い、ギターとの前後関係を扱い、現実の演奏とVirtualな表現を自然に混ぜることでした。
AIを作ることが目的ではない
この研究はまだ途中です。ただ、ここまでやってみて、AI研究は「もっと強いモデルを探して終わり」ではないということを強く感じています。
何を作りたいのか。どんな失敗が起きているのか。どんな撮影環境が扱いやすいのか。どんなデータを増やせばいいのか。そうしたことを行ったり来たりしながら進める必要がありました。
グリーンバックから始めたのに、途中で白壁の方が扱いやすいと気づいたのもそうです。Syntheticだけでは足りないと分かったあとにReal Dataを増やし、さらにSyntheticを補助的に戻したのもそうです。
遠回りに見えても、そういう試行錯誤の積み重ねが、最終的には一番効いていました。
次は、このGuitar SegmentationとHands Overlayをもっと自然につないで、本当に「Virtualな演奏動画」と呼べる形まで仕上げていきたいと思っています。
この研究について、今後書きたいこと
第一号なので、今回は研究全体の流れを優先しました。裏ではかなりいろいろな実験をしています。
- Synthetic Guitar Datasetをどう作ったか
- SAM3を使った実写データ作成
- FDSL / SegRCDBの転移学習
- LP-FTはSegmentationでも効くのか
- Multi-scale Featureは細い境界に効くのか
- Gabor / Phaseを境界検出に使えるか
- Real + Syntheticの比率をどう決めるか
このあたりは、今後それぞれ個別の記事として残していく予定です。