GUITAR AI / DATASET / COMPUTER VISION
AIの学習データが足りないので、自分のギターを5,000枚に増やした
グリーンバックなら簡単だと思った。実際には、撮影環境からSynthetic Dataの使い方まで試行錯誤することになりました。
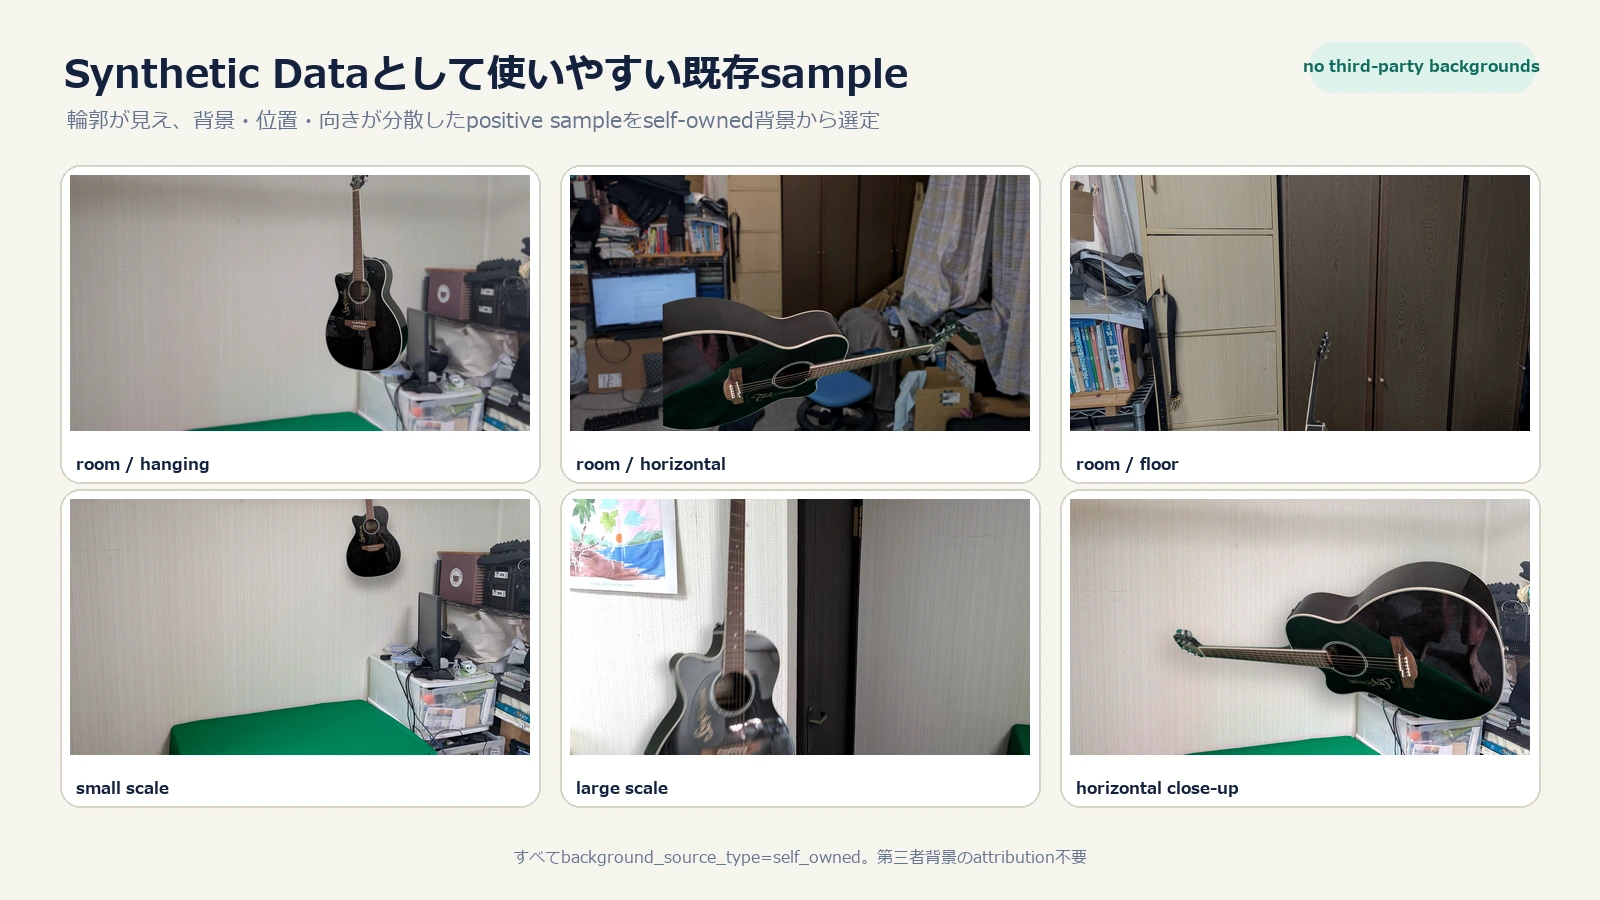
自分のギターだけを切り抜くAIを作ろう。
そう決めたあと、かなり早い段階で一つの問題にぶつかりました。
学習させる画像が足りない。
AIに「これが自分のギターだ」と覚えてもらうためには、いろいろな角度、位置、背景で撮影したギター画像と、その正解となるMaskが必要です。
数十枚程度なら自分で撮影できます。でも、学習データとして何千枚も用意しようとすると、一枚ずつ撮影して、一枚ずつ正解Maskを作る方法ではかなり大変です。
そこで考えました。
1本のギターを一度きれいに切り抜いて、背景や位置を変えながら何千枚にも増やせばいいのでは?
こうして、自分のギターを5,000枚に増やすことにしました。
まずは、グリーンバックで撮影してみた
最初に考えたのは、かなり単純な方法です。ギターの後ろを緑一色にして撮影する。そうすれば背景とギターを簡単に分離できるだろうと思いました。
そこでグリーンバックを用意し、自分のギターを角度や向きを変えながら撮影しました。
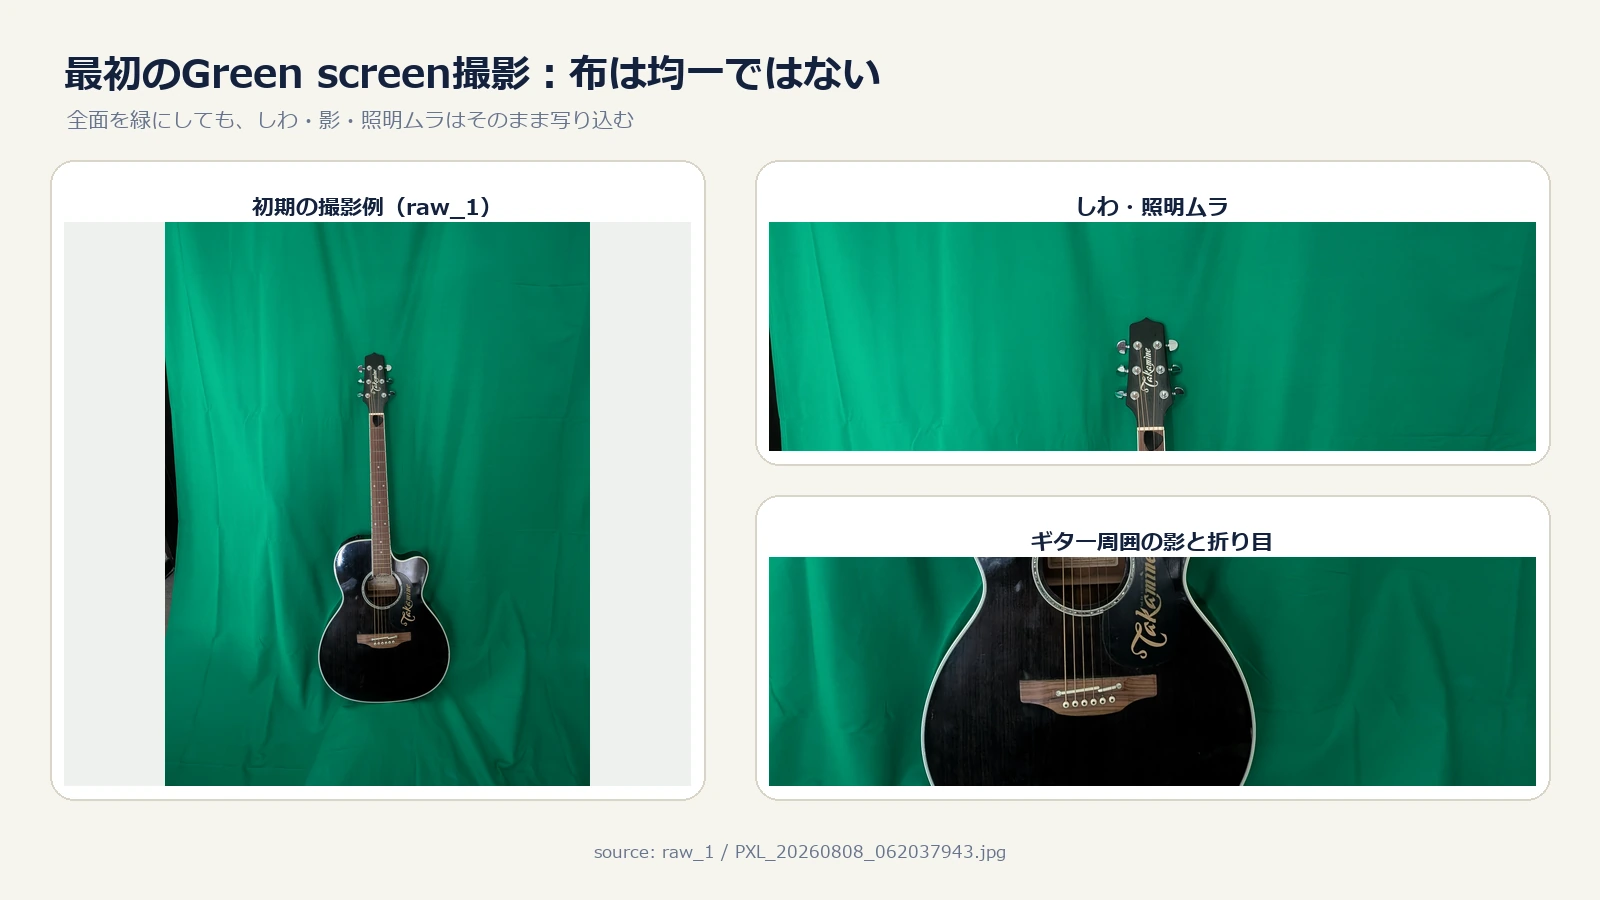
やってみると、グリーンバックは想像していたほど「背景が完全に一色になる仕組み」ではありませんでした。
布なので、どうしてもしわができます。しわができれば影ができます。照明の当たり方によっても、明るい緑と暗い緑ができます。
人間の目には「全部緑だから背景だよね」と簡単に分かります。でも画像として見ると、そこにはかなり大きな色や明るさの違いがあります。
グリーンバックを置けば、それだけで完璧な教師データが手に入るわけではありませんでした。
さらに、ギター自身が緑色になった
もう一つ予想していなかった問題がありました。反射です。
ギターにはペグなどの金属パーツがあります。その金属部分に、周囲のグリーンバックが映り込みました。
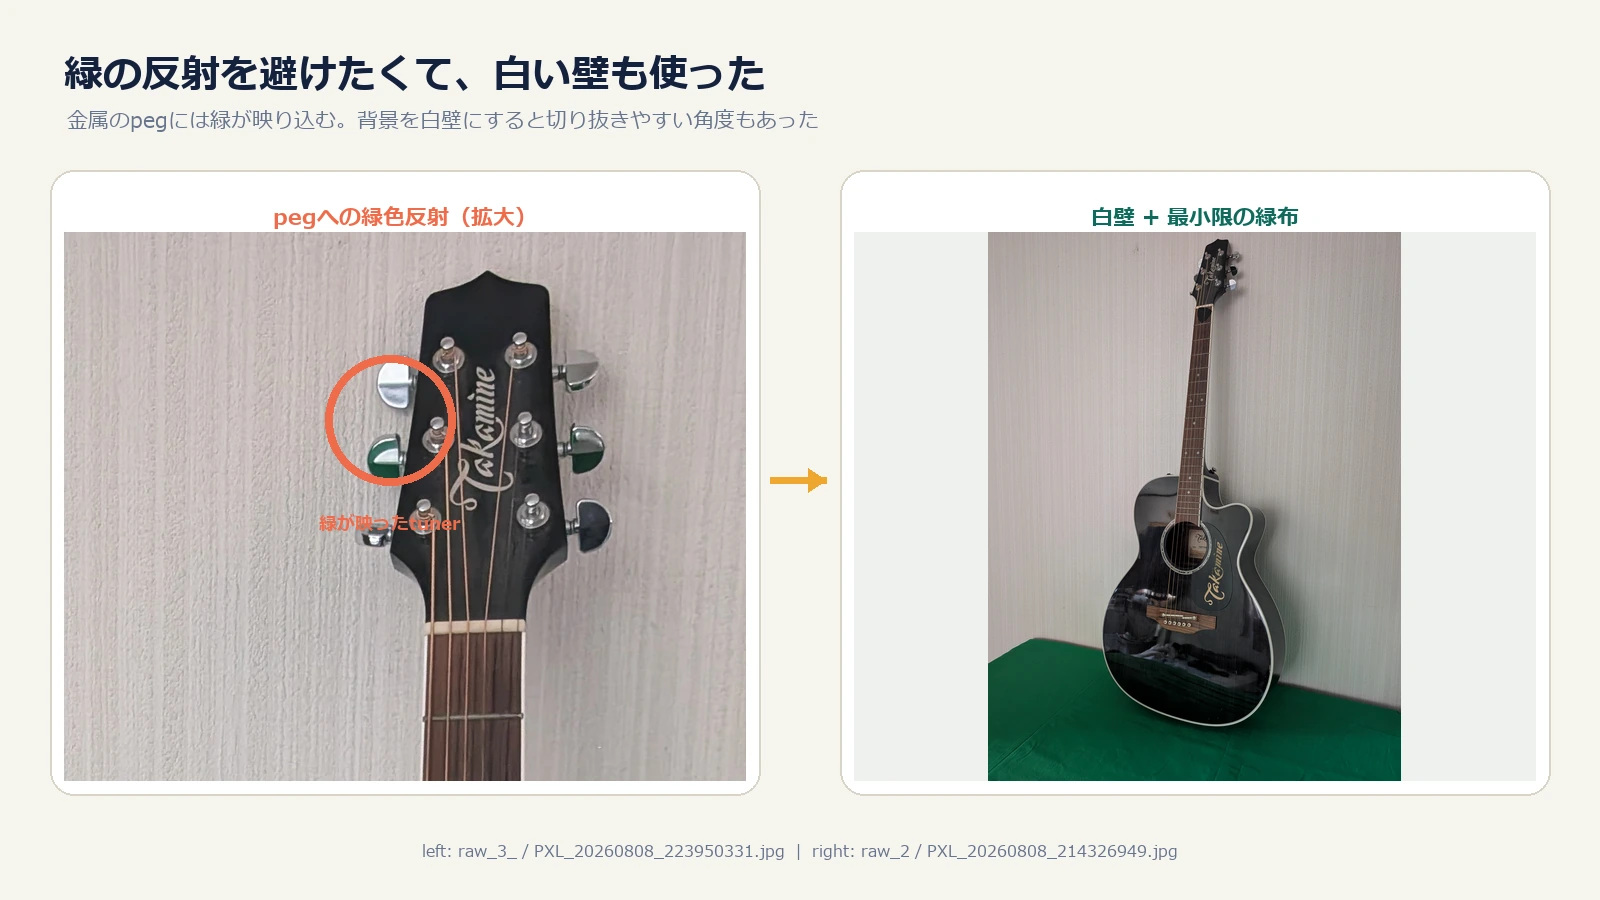
背景だけが緑ならまだ扱いやすいのですが、ギター自身の一部まで緑色になってしまいます。その状態でSAM系のモデルなどを使ってMask候補を作ると、ペグ周辺の境界が扱いにくいケースがありました。
そこで途中から、家の白い壁を背景として使うという方法も試しました。
専用の撮影設備でもありません。ただの白い壁です。でも、実際に使ってみると、こちらの方が扱いやすい場面がありました。
ここで目的を考え直しました。
欲しいのは「グリーンバックで撮った画像」ではなく、ギターと背景をきれいに分離できる素材。
それなら、必ずしも背景が緑である必要はありません。結果的に、最初は「ちゃんとした方法」だと思って導入したグリーンバックから、途中で白壁も使うようになりました。
AIモデルを作っていたはずなのに、いつの間にか撮影環境まで実験対象になっていました。
1枚のギターを、別の世界へ置いていく
撮影したギターから、最終的には人の目でも確認・修正したcutoutを作りました。ここからがSynthetic Data作りの本番です。
やること自体はシンプルです。ギターだけを切り抜いて、別の背景へ置く。
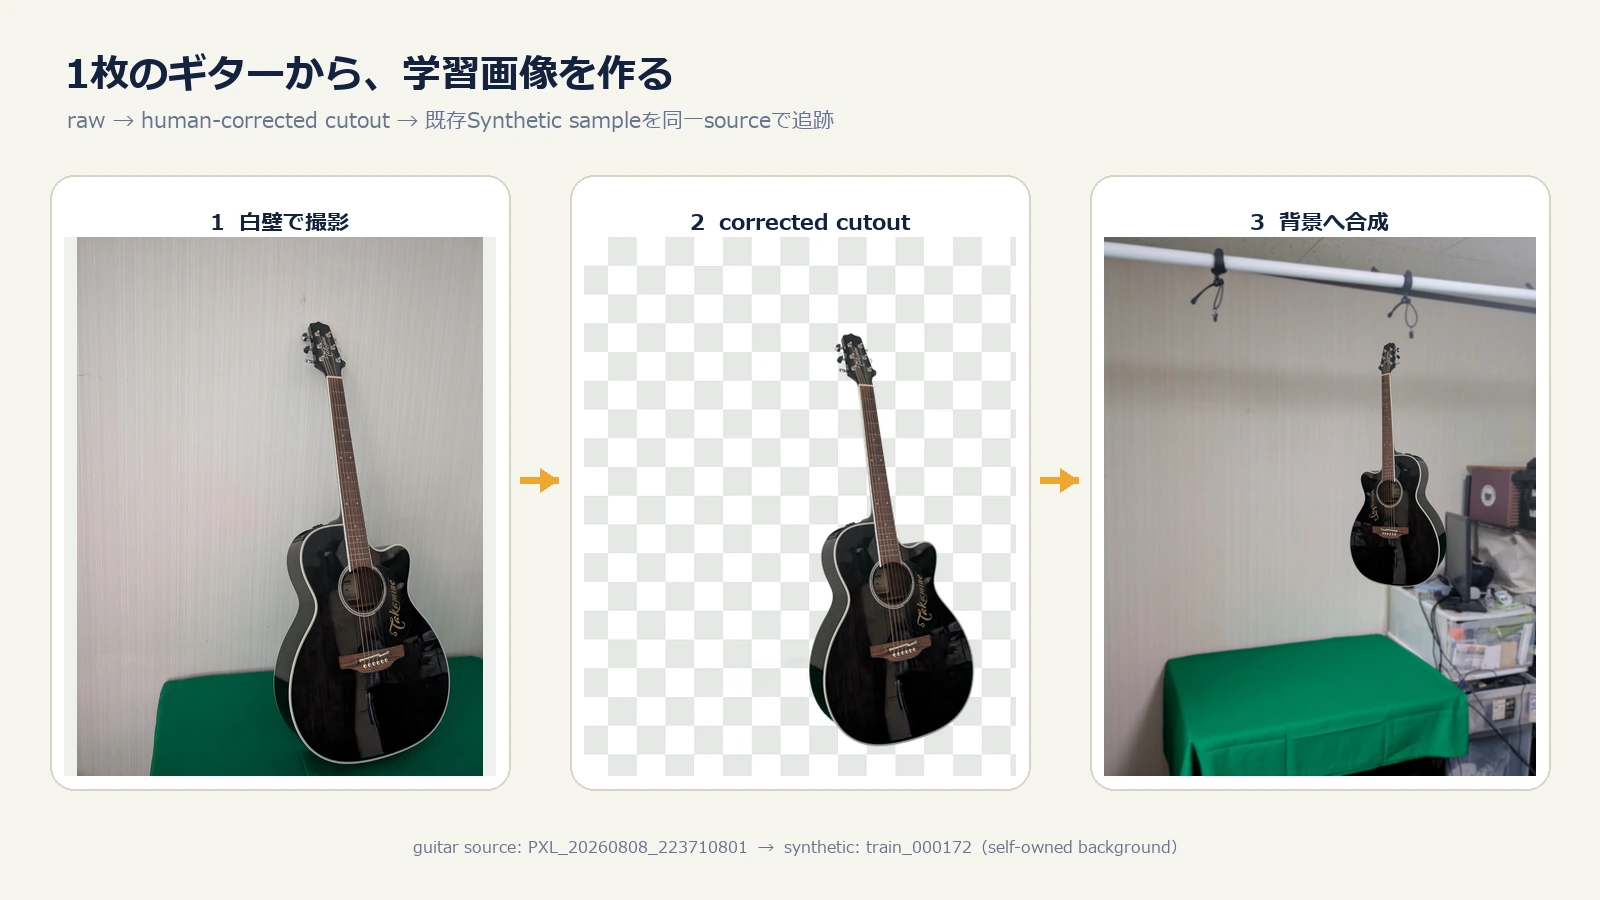
元の撮影画像では、当然ギターの背景は撮影した部屋です。でもギターだけを透明背景の画像として取り出してしまえば、部屋にも、屋外にも、まったく別の背景にも自由に置けます。
重要なのは、ギターそのもののMaskはすでに分かっていることです。実写データでは画像ごとにMaskを作る必要がありますが、Synthetic Dataなら一度正しいcutoutを作ったあと、背景を変えても正解Maskを自動的に生成できます。
同じギターなのに、かなり違う画像になる
同じcutoutを使っていても、背景を変えるだけで見た目はかなり変わります。さらに位置や大きさ、角度も変えました。
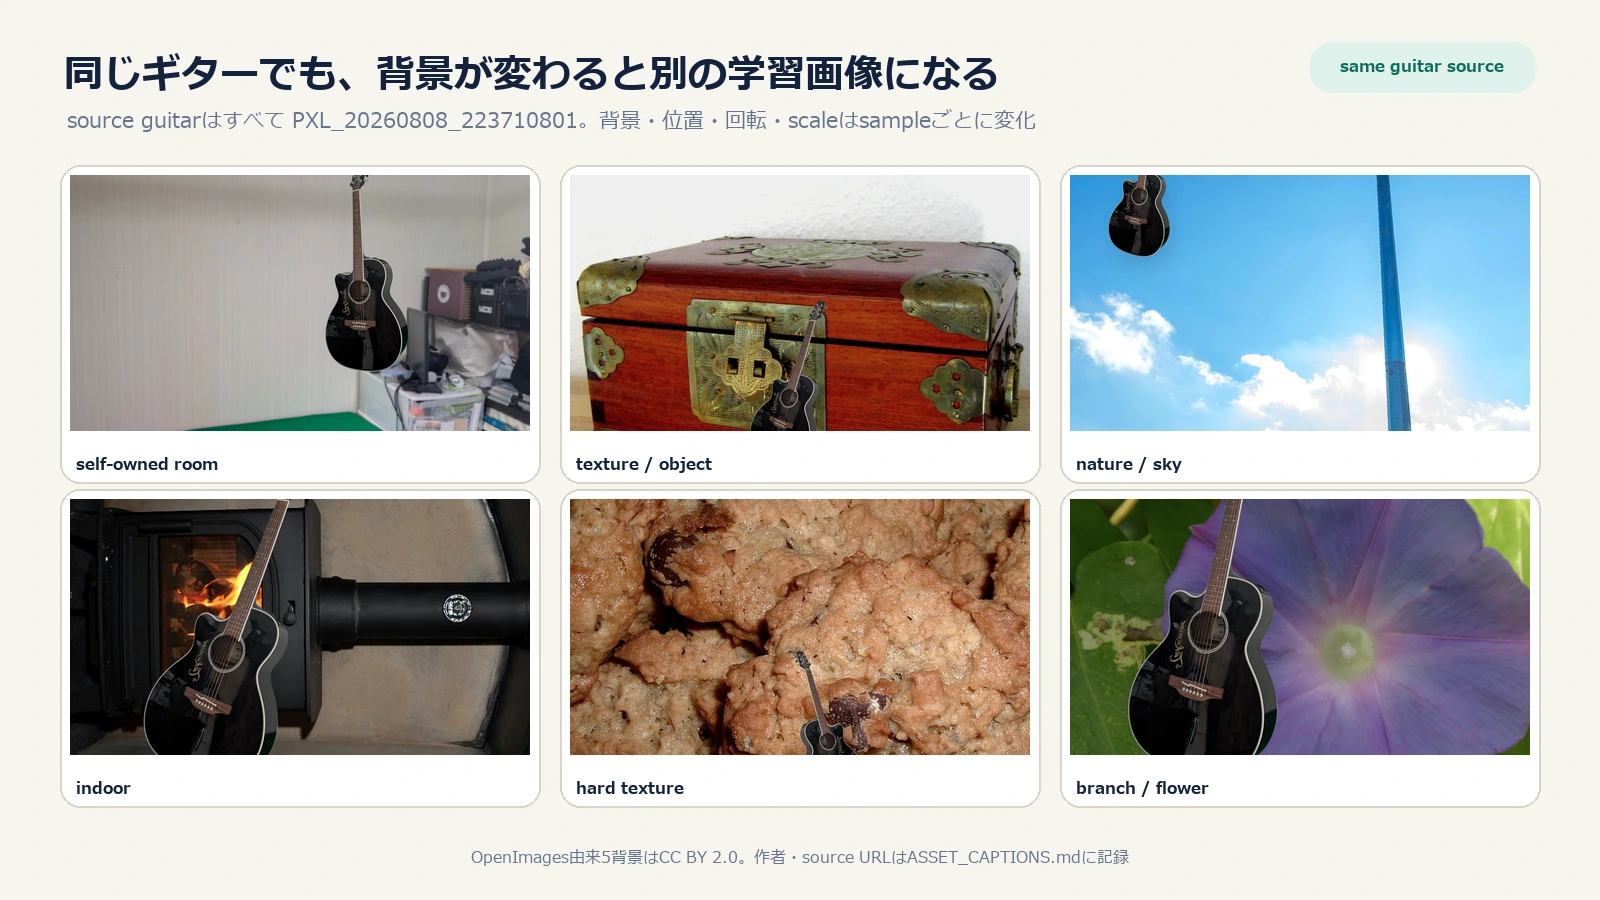
この図に写っているギターは、元をたどれば同じsourceです。でも、背景、画面内の位置、大きさ、角度が違うだけで、モデルから見た入力はかなり変化します。
「自分のギターを5,000枚に増やした」と書くと、本当に5,000回シャッターを切ったようにも聞こえますが、実際にやったことは、少数の良いギター素材から、条件を変えた学習画像を大量に生成することです。
背景だけでなく、ギターの見え方も変える
背景だけを交換すると、「このギターはいつも同じ大きさ、同じ向きで出てくる」という不自然なDatasetになってしまいます。
そこで、合成するときの条件もrandomizeしました。
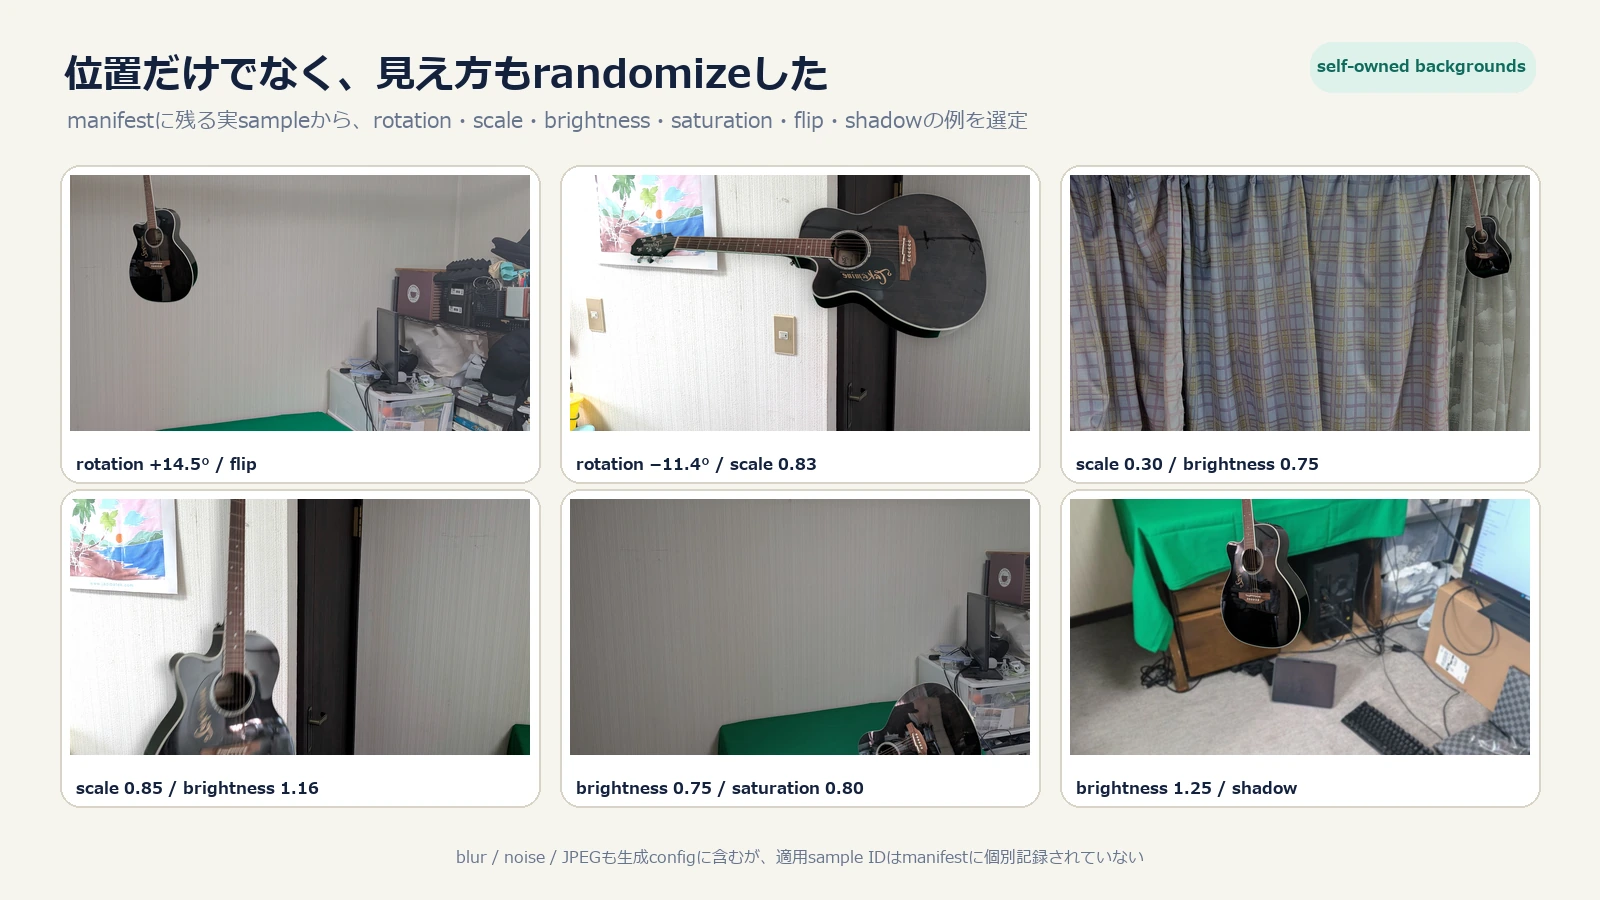
具体的には、回転、大きさ、位置、左右反転、明るさ、Contrast、Saturation、影などです。生成設定にはBlur、Noise、JPEG劣化も含めました。
ただし上の図では、sample単位で適用を確認できたrotation、scale、flip、brightness、saturation、shadowだけを実例として載せています。
AIに必要なのは、同じ画像を5,000回見せることではありません。少しずつ違う状況を見せて、「背景や明るさが変わっても、ここまでがギター」と学習してもらう必要があります。
そして、5,000枚になった
こうして完成したDatasetを、GuitarSynthetic_v1と呼んでいます。
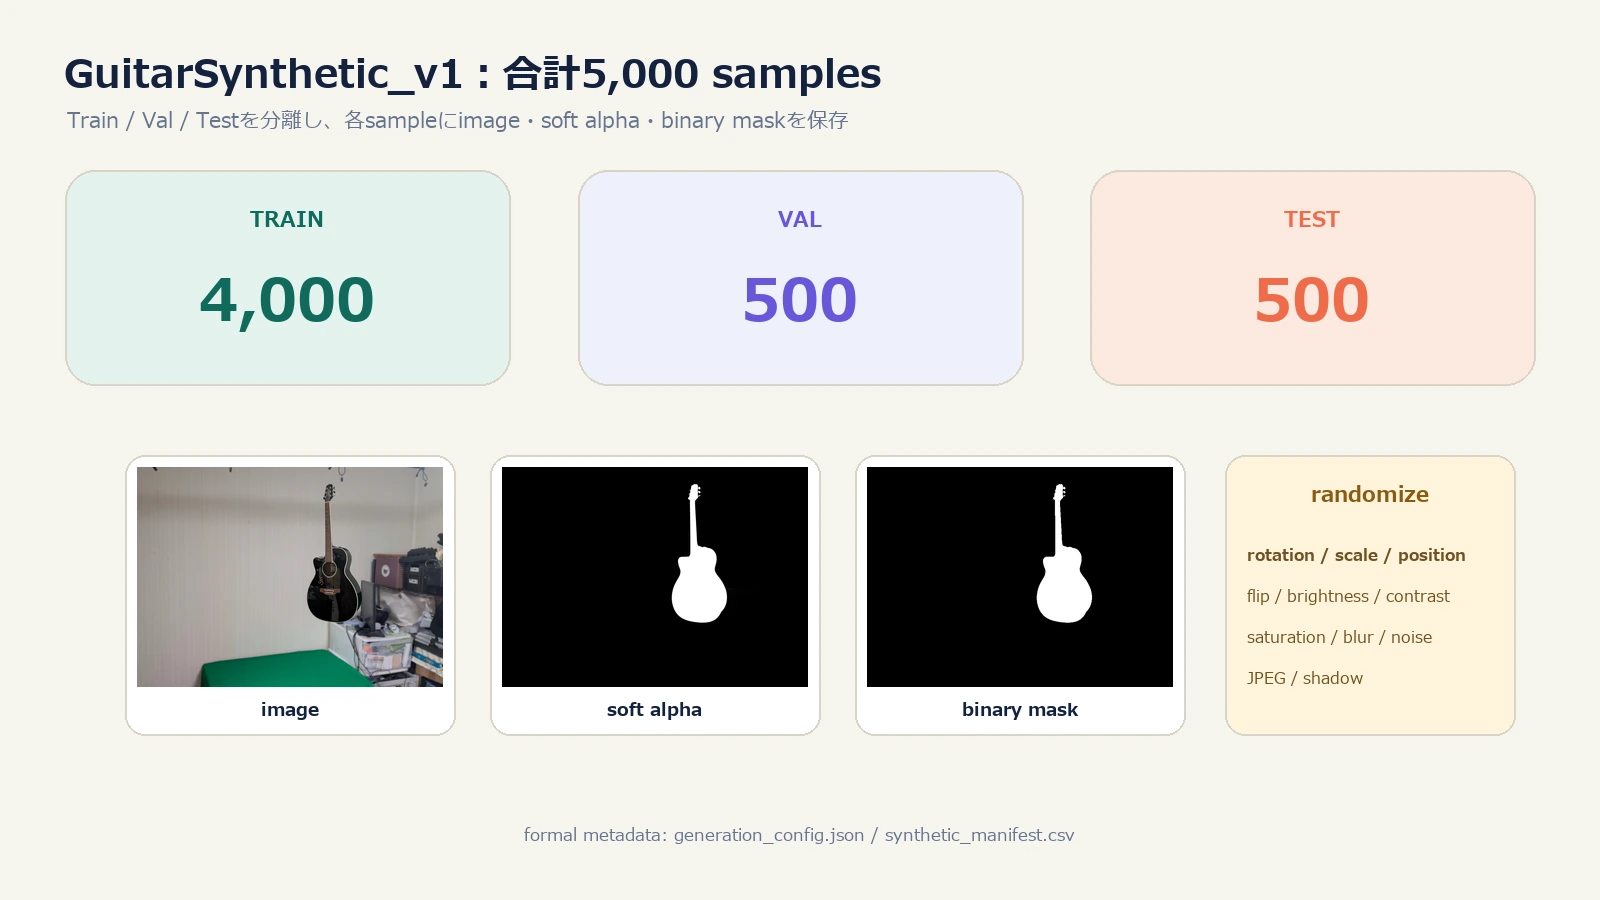
各sampleには、普通の合成画像だけでなく、soft alphaとbinary maskも保存しています。つまり、AIへ渡す画像と「どこがギターか」という正解がセットになっています。
最初に「学習画像が足りない」というところから始まったので、5,000という数字を見たときは、かなり増やせた感覚がありました。
5,000枚あれば解決する……とはならなかった
ここまで来ると、「これだけあれば、かなり強いギターAIになるのでは?」と思いたくなります。実際、Synthetic Datasetの中ではかなり良い性能が出るようになりました。
しかし、実際の演奏映像へ持っていくと問題が起きました。
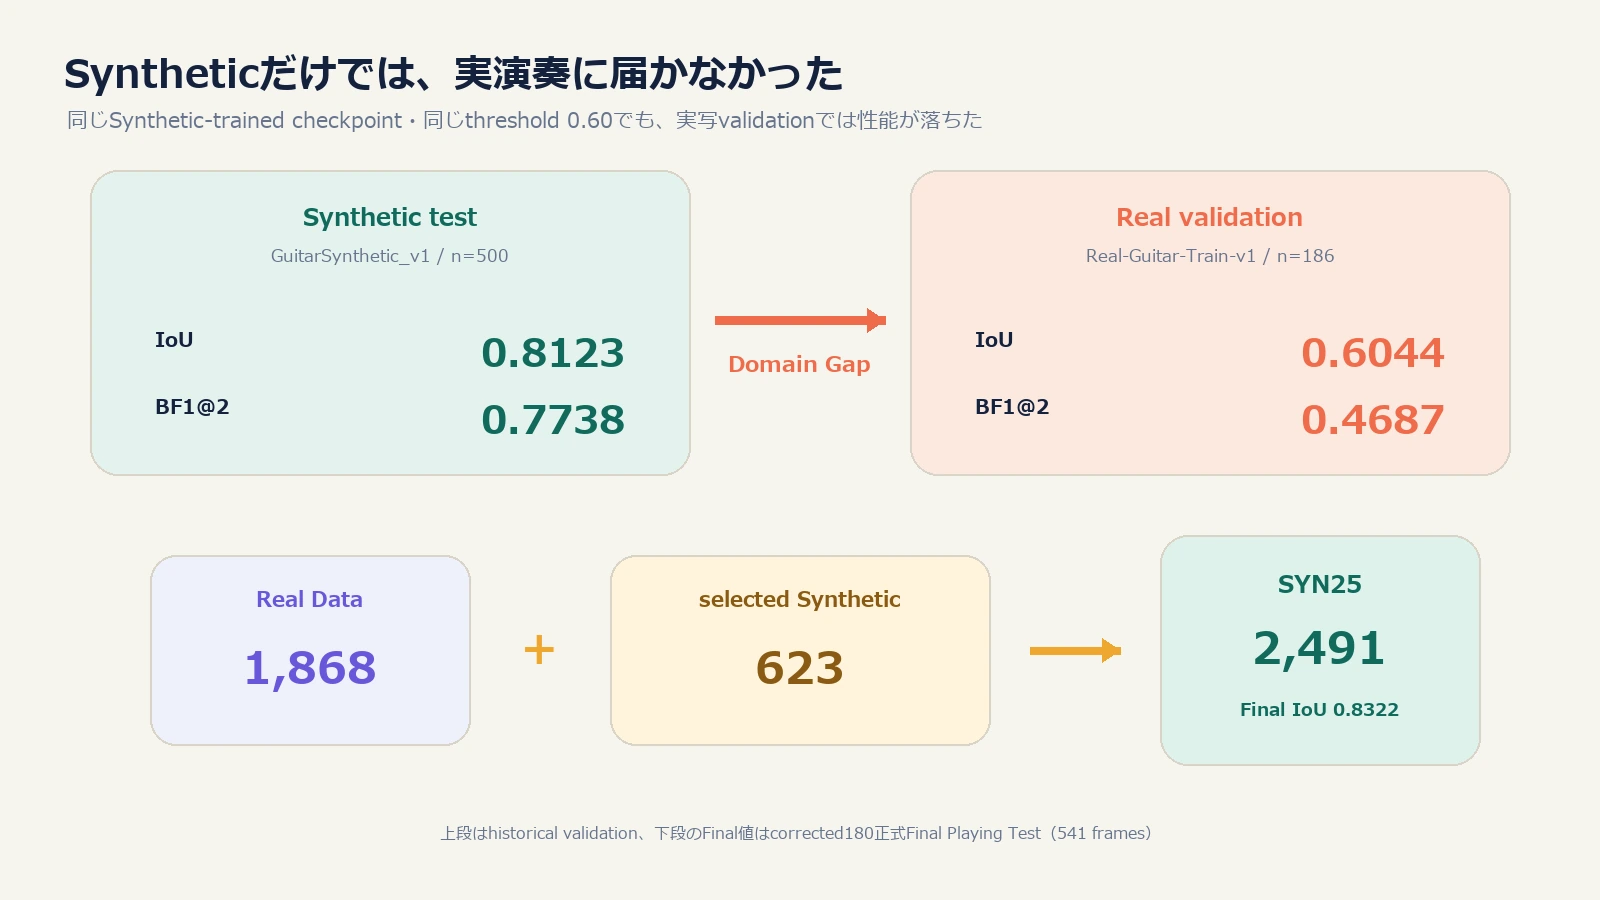
図の上段は、同じSynthetic-trained checkpoint・同じthresholdで、Synthetic test 500枚とReal validation 186枚を評価した結果です。
Synthetic Dataではギター単体を背景へ置いています。でも本当の演奏では、手がネックを握り、腕がボディに重なり、服の袖がギターと接触します。髪や身体、椅子、部屋の物体も入り、動けばMotion Blurも発生します。
つまり、「いろいろな背景に置かれたギター」と「人間が実際に弾いているギター」は、似ているようでかなり違うDatasetでした。
では、Synthetic Data作りは失敗だったのか
ここが今回、一番面白かったところです。
Syntheticだけでは実演奏に届かなかった。だから「Synthetic Dataは意味がなかった」とも考えられます。でも実際には、そうなりませんでした。
その後、実際の演奏やHard-caseを含むReal Dataを増やしました。Real Dataが1,868枚まで増えた段階で、Syntheticを全部使うのではなく、そこから選んだ623枚を補助的に戻しました。
Realには、人とギターの接触、手や腕、服、実際の演奏環境を担当してもらう。Syntheticには、ギターの形、角度、位置、Scaleなどの多様性を補ってもらう。役割を分けました。
その後の正式なFinal Playing Testでは、SYN25条件でIoU 0.8322まで到達しました。
Syntheticが悪かったのではなく、Syntheticだけですべてを解決しようとしたことに無理があった。
データを増やすことと、現実を増やすことは違う
今回5,000枚のDatasetを作ってみて、一番印象に残ったのはここです。画像を5,000枚に増やすこと自体はできました。しかも、かなり自動化できます。
でも、画像枚数を増やすことと、現実世界の多様性を増やすことは同じではありません。
背景を100種類にしても、手がネックを握るという現象は生まれません。回転角度をrandomizeしても、長袖とギターが触れる境界は生まれません。
逆に、同じギターを違うScaleで何百回も出したり、背景を大量に交換したり、明るさを変えたりするのはSyntheticの方がはるかに簡単です。
だから今は、RealかSyntheticかという二択で考えない方が良いと思っています。
AIを作っていたら、撮影方法まで研究することになった
最初にやりたかったことはシンプルでした。自分のギターを切り抜くAIを作る。そのために学習データが必要だった。だからグリーンバックを用意した。
でもグリーンバックにはしわができた。金属には緑色が反射した。そこで白壁も使った。そこからcutoutを作って、背景へ合成して、5,000枚へ増やした。
そして5,000枚作ったあとに、本物の演奏は、それとはまた違うと気づきました。
AIモデルそのものよりも、「何を撮るか」「どう撮るか」「何をSyntheticで作るか」「何をRealで集めるか」を考えていた時間の方が長かったかもしれません。
次は「実際に失敗する場面」を集めた
Synthetic Datasetを作ったことで、ギターそのものの多様性はかなり増やせました。一方で、実演奏とのDomain Gapも見えてきました。
そこで次にやったのが、モデルが実際に失敗する場面を狙って、Real Dataを増やすことです。
手や腕で隠れる場面。人しかいない場面。背景しかない場面。長袖とギターが接触する場面。
続きでは、「良いデータを増やす」のではなく、AIが間違えるデータを増やしたらどうなったかをまとめています。
IMAGE CREDITS
背景画像のクレジット
「同じギターなのに、かなり違う画像になる」の図では、Open Images V7経由のCC BY 2.0背景写真を5点使用しています。各画像はcrop・resizeしたうえでギターを合成しています。
License: Creative Commons Attribution 2.0